大模型概述
大模型基本原理
大语言模型本质上是一种基于海量文本训练得到的文本生成模型 有非常大的参数 大模型会给文本分词,分词规则由大量的词语统计出来的 这些词就是token 每一个token都会通过词表映射得到数据的表示
温度: 温度越高大模型输入就更灵活 温度越低越固定(就会把概率变得更陡,高分越突出) 大模型是基于非常大的语料
大模型结构
大模型大多基于Transformer 最早用做自然语言处理 llm-->NLP 一个NLP一般是做特定的事情,llm是在nlp的基础上完成的
transformer是由Encoder(编码器)和Decoder(解码器)组成 Encoder输出一个向量, Decoder基于Encoder生成的向量一个一个生成回答token 最终可以得到回答的答案
《Attention Is All You Need》 论文只要是使用了Attention会大量减少时间(本来计算资源非常大) 使用了attention了能否扩大训练文本
现在为了更节省资源吧encoder去掉了 现在语言模型都是Decoder-only
输入层
把用户输入文本token_id转化成向量,
Transformer
堆叠层,每一层里面包含注意力机制和前馈神经网络 注意力机制:和前文中的进行联系,更新最后要拼接到最后的文字上 这个文字包含前文所有的语义 (这些上下文需要多层堆叠才能表示出来)
输出层
堆叠层之后,此时输出向量包含所有的语义信息 如何获取概率分布 一层向量 乘以参数矩阵 例如14096 ==>14096 * 409615w --->115w 原来维度转换为词表维度的概率分布 就得到了词表大小的向量即可以理解为概率分布
大模型发展历史
- 预训练:给模型非常大的文本,纯词语接龙的训练 经过预训练之后会让模型有续写的能力 并不会回答你问的问题 但是得先有续写能力再往后
- 监督微调(SFT) 需要人工构造质量响应或者高质量对话数据对模型进一步训练 使其更换理解指令,解决预训练所能解决的问题
- 对齐(Alignment) 通过引入人类偏好,行为规范,安全约束和价值观等因素 针对某一个问题,让模型有合适的价值观
大模型适配
把一个通用模型适配到大模型里
提示词工程
简单适配方式
微调
构造一些数据,让模型再去做一些训练 就只是拿几千条几万条数据即可训练好 通过这种让模型更加稳定执行特定任务.格式,语气或业务风格 ==>节约成本,自部署模型就需要微调
检索增强生成
rag缺点是流程太长 微调就是为了将只是内化到llm上去
微调整体流程
可以分为多个环节 模型选择--->数据准备--->微调训练--->模型验证
garbage in garbage out
模型验证
评估模型是否真正学习到目标任务能力
微调数据准备
- 公共数据库
- 私有数据库:需要清洗结构化等(不像公共数据集,开箱即用)
数据集格式
分为两种:指令式(Alpaca),对话式
指令式: { "instruction": "将以下英文翻译成中文", "input": "Large language models are transforming AI.", "output": "大语言模型正在改变人工智能。" }
对话式: (1)ShareGPT格式 有角色和内容的格式 (2)OpenAI格式 role:发言者 content:对话内容
全参数微调
方法选择 LoRA QLoRA
LoRA:
当矩阵行数和列数都大于矩阵的秩就是一个低秩矩阵 增量矩阵是低秩矩阵,即可以分为两个矩阵相乘,比训练原增量矩阵小很多 原本矩阵是要训练dk个数值 而现在只需要 dr + k*r的参数 这样参数大量减少了 r取得小就会让数据变得更小,但是也可能会没有学够知识 r变大就可以更好让大模型学到知识 在大模型训练过程中很多都是自定义 通过训练两个矩阵得到增量矩阵 之后把增量矩阵与原始矩阵合并 即得到最终的形式 总结:训练ab两个矩阵去代替训练完整的增量矩阵,从而节省资源
QLoRA
量化和反量化 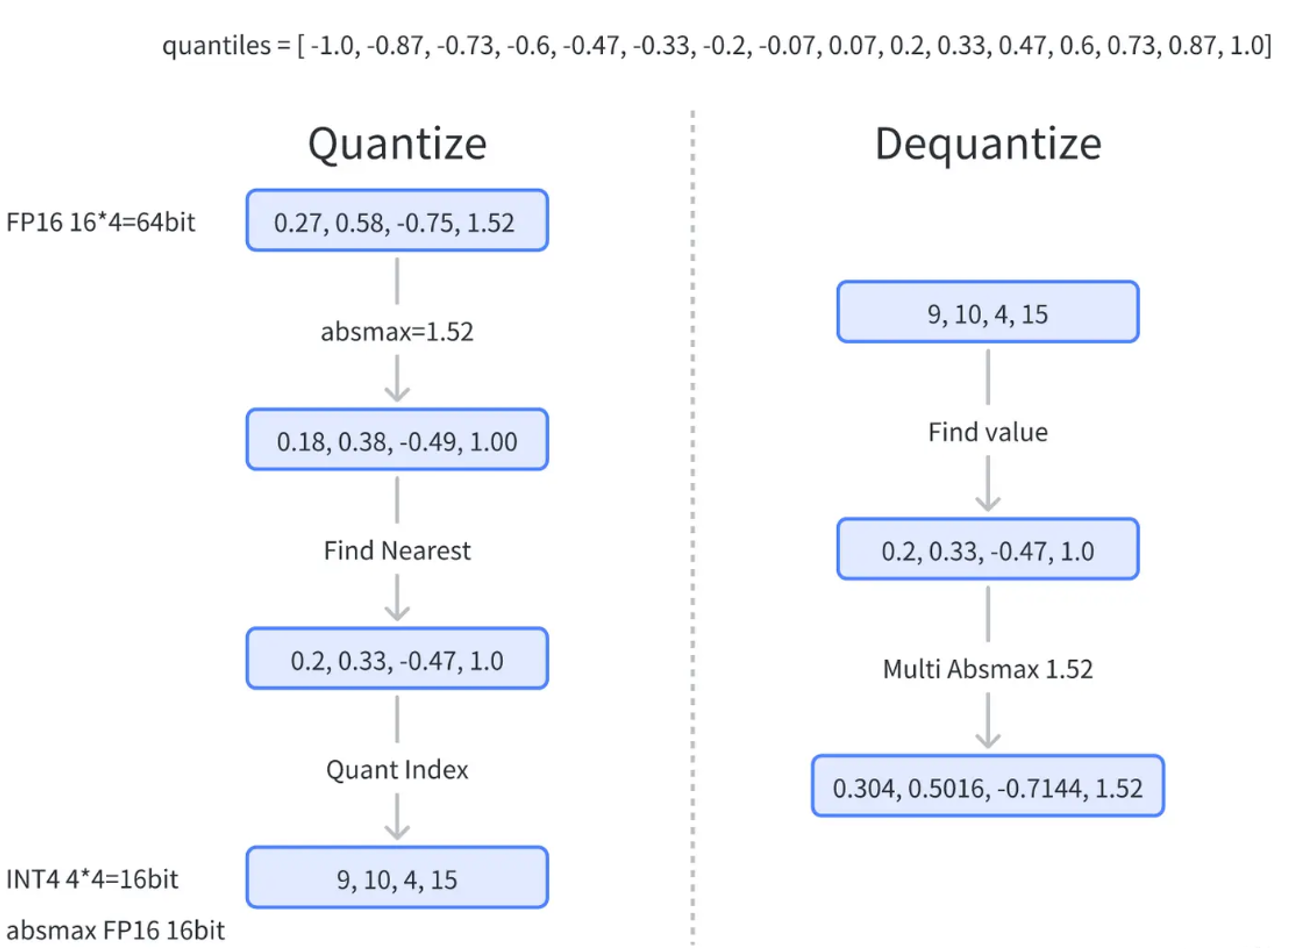 对于传统的优化(NF4 量化) 让量化点的划分服从正态分布,从而减小误差
QLoRA 就是 NF4 量化
补充整理:QLoRA = 量化后的基座模型 + LoRA 适配器。要点是——
- 基座模型用 4-bit NF4 量化加载(显存降到约 1/4),权重被冻结、不训练
- 只训练插入的 LoRA 适配器,适配器本身用 bf16 正常精度
- 训练时按需反量化基座权重参与计算,用完即弃,不长期占用显存
- 再配合**分页优化器(paged optimizers)**应对显存峰值
效果:单张 24GB 消费级显卡(如 3090/4090)就能微调 30B 级别的模型, 这是它最实际的价值。代价是训练速度比全精度慢一些。
微调方法怎么选
补充整理:三种方法的取舍——
方法 显存 效果 适用场景 全参数微调 极高(约 16–20× 模型大小) 上限最高,易灾难性遗忘 数据充足(十万级以上)、算力充足 LoRA 中(约 2× 模型大小) 接近全参数 默认首选,性价比最高 QLoRA 低(单卡可跑大模型) 略低于 LoRA 显卡受限、想跑更大基座 经验:先用 LoRA 起步,效果不够再考虑全参数;数据质量比方法选择影响更大。
关于秩
r的选择:
r小(8–16):参数少、训练快,但表达能力有限r大(32–64):能学到更多,但过拟合风险和显存都上升- 常用起点
r=16, alpha=32(alpha 通常为 2×r),dropout=0.05target_modules一般覆盖注意力层的 q/k/v/o 投影,复杂任务再加上 FFN
分布式训练
补充整理:三种并行方式切的是不同维度,组合使用才能训动大模型——
方式 切的维度 每张卡持有 主要瓶颈 数据并行 DP 数据(batch 拆开) 完整模型副本 显存冗余、梯度同步通信 流水线并行 PP 模型层(按层竖切) 连续若干层 流水线气泡(bubble) 张量并行 TP 层内矩阵(横切) 每层的部分权重 层内通信极频繁,需高带宽(NVLink)
数据并行
多张 GPU 上各放置一份完整的模型副本
补充整理:每张卡吃不同的 mini-batch,各自算前向反向, 再把梯度做一次 All-Reduce 求平均后同步更新。 优点是实现简单;缺点是每张卡都存一份完整模型 + 梯度 + 优化器状态,显存冗余极大 (这正是 ZeRO 要解决的问题)。
流水线并行
针对模型太大了,按照层数方向对模型切分
补充整理:把 32 层模型按 8 层一段分给 4 张卡,像工厂流水线一样传递激活值。 问题是有「气泡」——下游卡在等上游算完时是空闲的,所以要把 batch 再切成 更小的 micro-batch 轮流灌进去,才能把流水线填满。
张量并行
在层内部对矩阵运算切分
补充整理:把一次大矩阵乘法按列(或行)劈成几块,每张卡算一块, 再把结果拼起来(列并行后接 All-Gather,行并行后接 All-Reduce)。 通信发生在每一层内部,频率极高,所以通常只在单机多卡(NVLink)内用, 跨机用会因为网络延迟拖垮训练。
ZeRO 技术
概述及核心原理
对数据并行做了优化,认为不需要每张卡存储所有参数,觉得冗余
补充整理:原稿「比全切分块」应为「比全切分快」,「存储所以参数」应为「存储所有参数」。
显存都花在哪了?训练时一张卡要存:
- 模型参数(Parameters)
- 梯度(Gradients)
- 优化器状态(Optimizer States) —— 最占地方
以 Adam 为例,优化器状态包含一阶动量 m 和二阶动量 v,加上 fp32 主权重, 每个参数要额外占约 16 字节。所以 7B 模型光优化器状态就要 100GB 以上。
ZeRO(Zero Redundancy Optimizer)的思路是:数据并行时这些状态没必要每张卡都存一份, 把它们切开,谁用谁去取。 分三个阶段逐步递进:
阶段 切分对象 显存节省 通信开销 ZeRO-1 优化器状态 ~4× 与数据并行相当 ZeRO-2 + 梯度 ~8× 略增 ZeRO-3 + 模型参数 与卡数成正比 最大,通信最频繁 对应原稿的三句话:
- 「只对优化器状态切分」= ZeRO-1:优化器最占显存,切它性价比最高,几乎不牺牲速度
- 「不切分模型参数」= ZeRO-2:再切梯度,比全切分快
- 「全切分」= ZeRO-3:显存最省但速度最慢,因为每层算前都要先把参数 All-Gather 回来
实践建议:先试 ZeRO-2,显存还不够再上 ZeRO-3;ZeRO-3 一定要配梯度检查点 (gradient checkpointing)和高性能互联,否则会慢到不能接受。
微调实操
补充整理:原稿这一节是空的,下面补一份可执行的落地流程 (以 LLaMA-Factory 为例,它是目前最省事的国产微调框架)。
1. 环境准备
bashgit clone https://github.com/hiyouga/LLaMA-Factory.git cd LLaMA-Factory pip install -e ".[torch,metrics]"2. 准备数据(Alpaca 指令格式)
data/my_task.json:json[ { "instruction": "将下面的技术术语翻译成通俗解释", "input": "检索增强生成", "output": "先去资料库里查出相关内容,再让模型结合这些内容回答你。" } ]然后在
data/dataset_info.json里注册这个文件名,框架才能识别。3. 启动 LoRA 微调
bashllamafactory-cli train \ --model_name_or_path Qwen/Qwen2.5-7B-Instruct \ --stage sft \ --dataset my_task \ --template qwen \ --finetuning_type lora \ --lora_rank 16 \ --lora_alpha 32 \ --learning_rate 1e-4 \ --num_train_epochs 3 \ --per_device_train_batch_size 2 \ --gradient_accumulation_steps 8 \ --output_dir saves/qwen-lora \ --bf16关键参数怎么调:
learning_rate:LoRA 用1e-4量级,全参数微调用1e-5量级,差一个数量级num_train_epochs:小数据集 3–5 轮,多了会过拟合per_device_train_batch_size×gradient_accumulation_steps= 有效 batch size, 显存不够就调小前者、调大后者- 损失曲线:训练集 loss 一直降、验证集 loss 反弹,就是过拟合了
4. 合并与部署
bash# 把 LoRA 权重合并回基座,得到一个完整模型 llamafactory-cli export \ --model_name_or_path Qwen/Qwen2.5-7B-Instruct \ --adapter_name_or_path saves/qwen-lora \ --export_dir merged/qwen-sft # 用 vLLM 起推理服务(吞吐比原生 transformers 高数倍) python -m vllm.entrypoints.openai.api_server \ --model merged/qwen-sft \ --served-model-name qwen-sft5. 效果验证
不能只靠「感觉变好了」。至少做三件事:
- 留一批没参与训练的测试集,跑客观指标(分类看准确率,生成看人工/模型打分)
- 和基座模型 + 提示词对比,确认微调确实带来了增量(很多时候精心写提示词就够了)
- 检查灾难性遗忘:微调后通用能力有没有明显退化
一句话总结流程:先想清楚能不能用提示词/RAG 解决,解决不了再微调; 微调的核心工作量在数据清洗,不在跑命令。