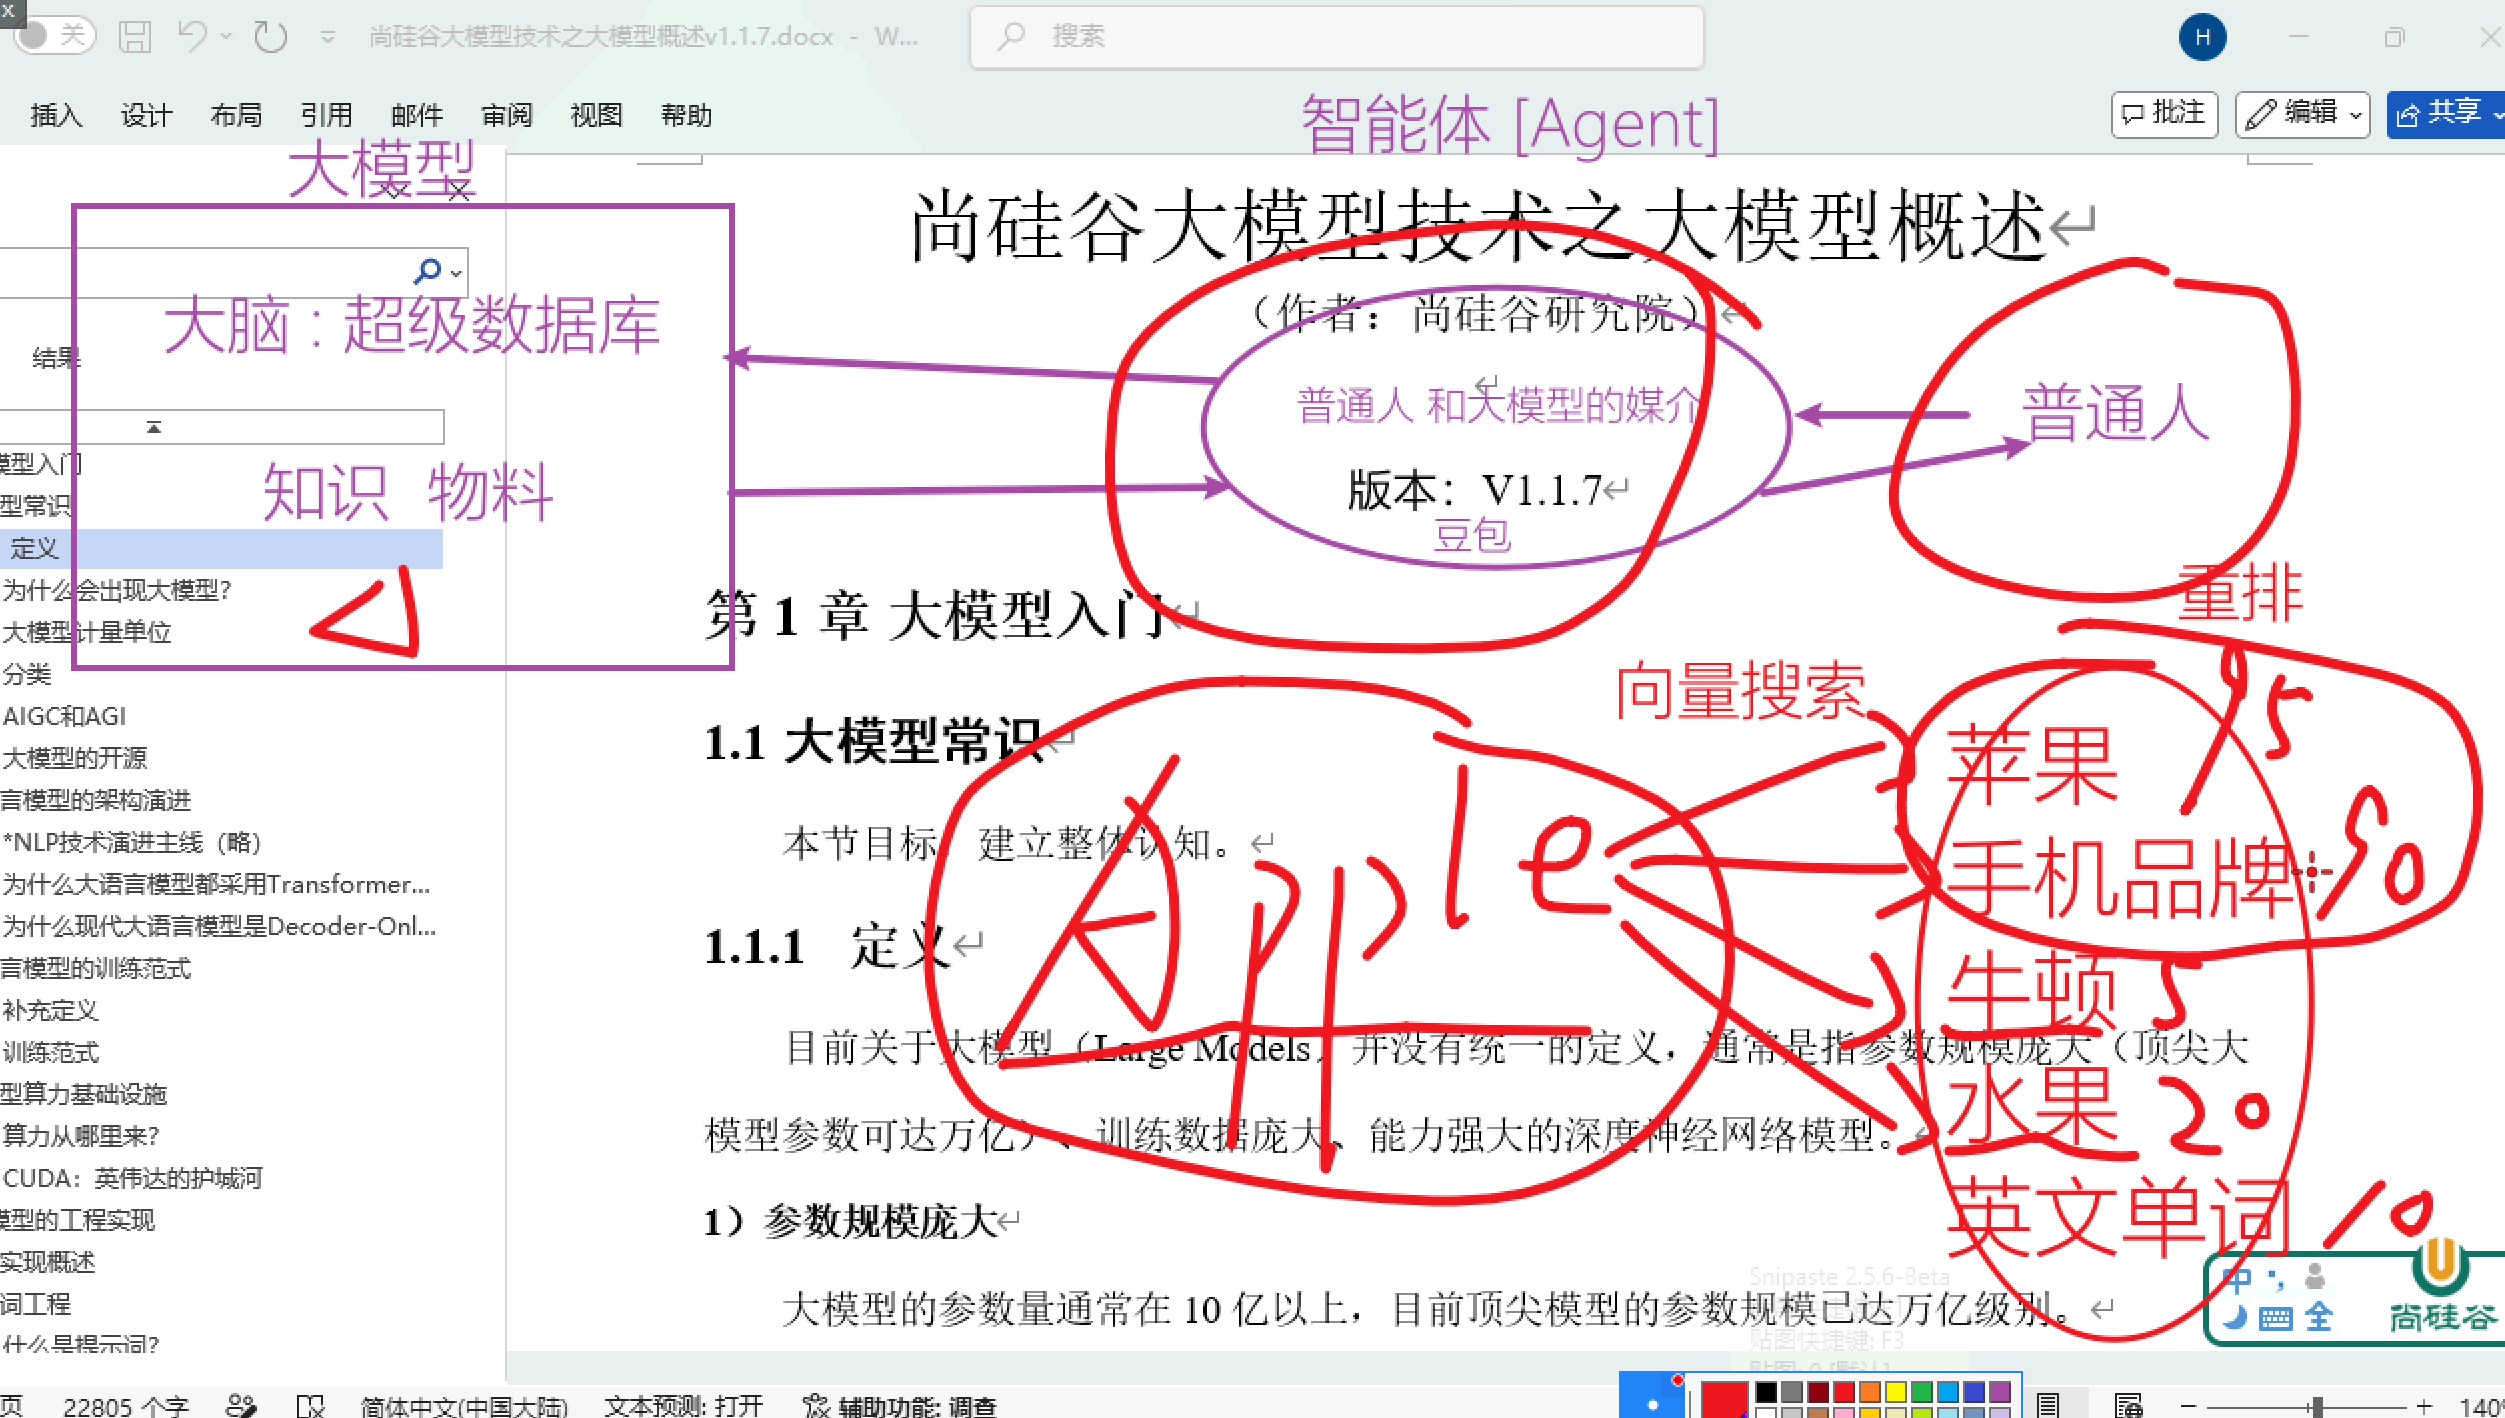
大模型 ——> 脑子 智能体 ——> 连接
大模型(Large Models)
LLM ——> 大语言模型 ——> 是大模型的一种 通常指参数规模庞大、训练数据庞大、能力强大的深度神经网络模型(类比脑中的突触连接)
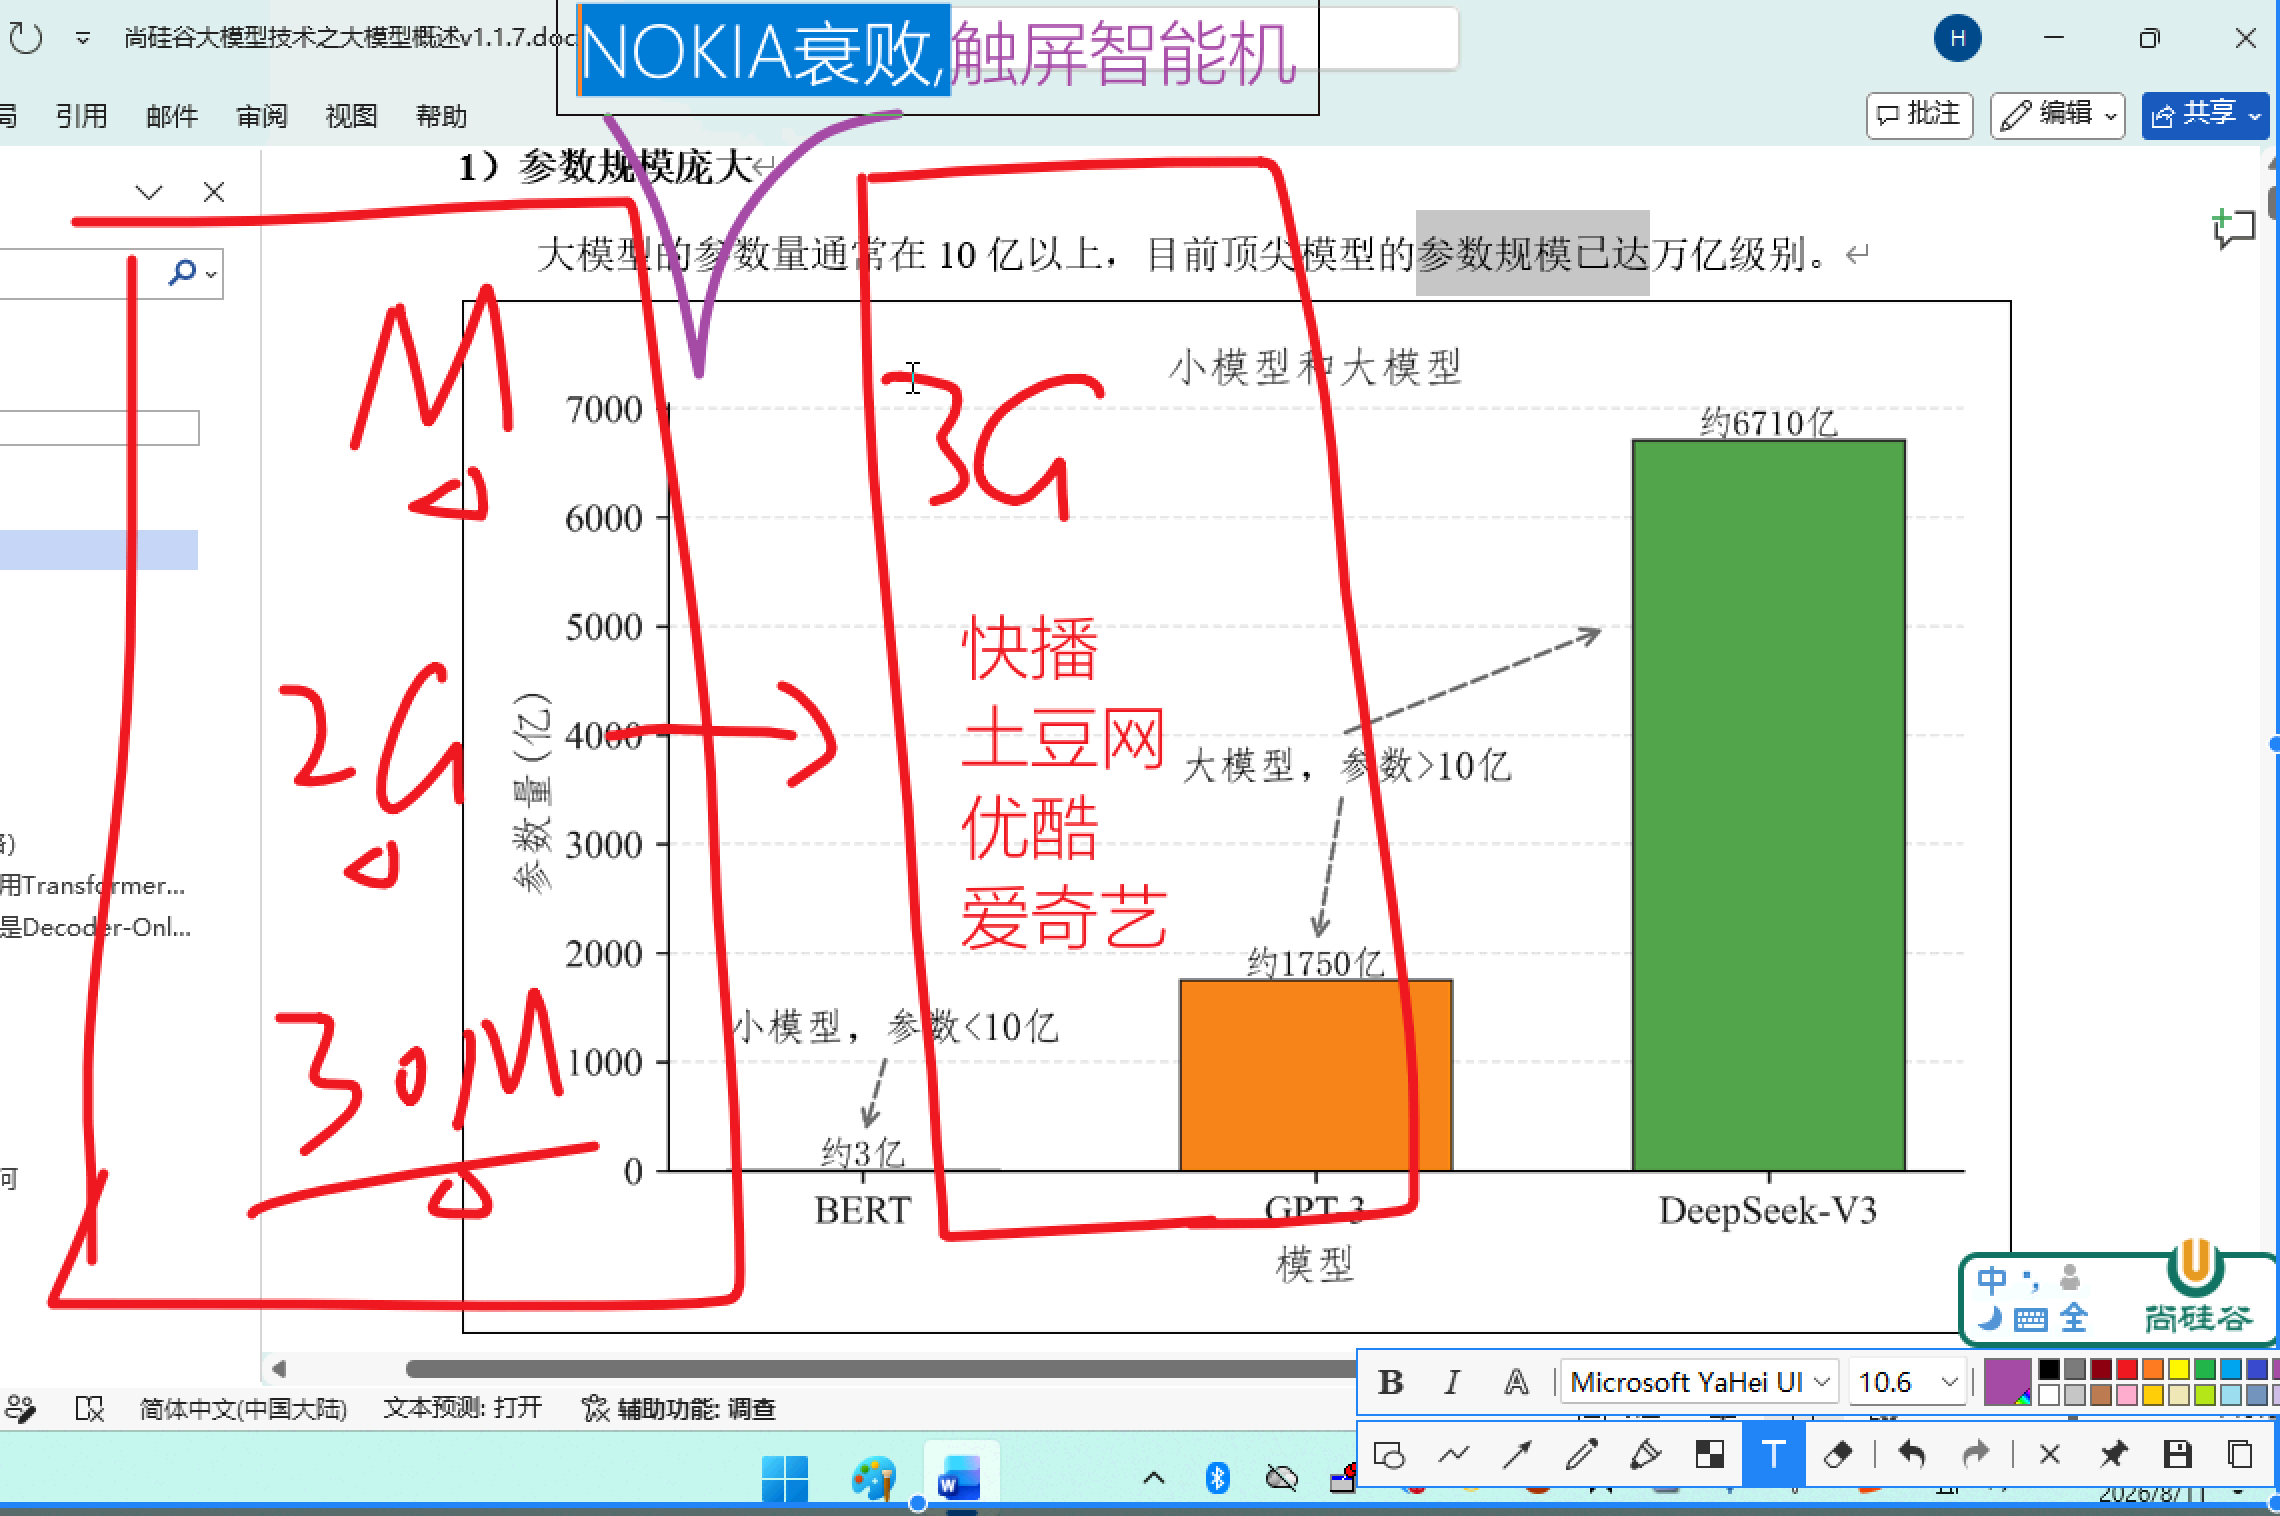
- 参数规模庞大:目前顶尖模型的参数规模已经达到万亿级别
- 训练数据庞大
- 能力强大
为什么出现大模型
数据更多:传统监督学习高度依赖人工标注(分类标注、命名实体识别);大模型采用自监督学习范式(如预测下一个 token),不需要人工标注
算力够强:GPU/TPU 等并行计算设备性能发展与分布式训练成熟;深度学习训练本质是大规模矩阵运算,具有高度并行性;与此同时,数据并行、张量并行、流水线并行等分布式训练体系成熟
架构合理:Transformer:Transformer 摒弃了强序列依赖的递归计算方式,并支持并行计算,计算量越大损失的性能就越小
大模型计量单位
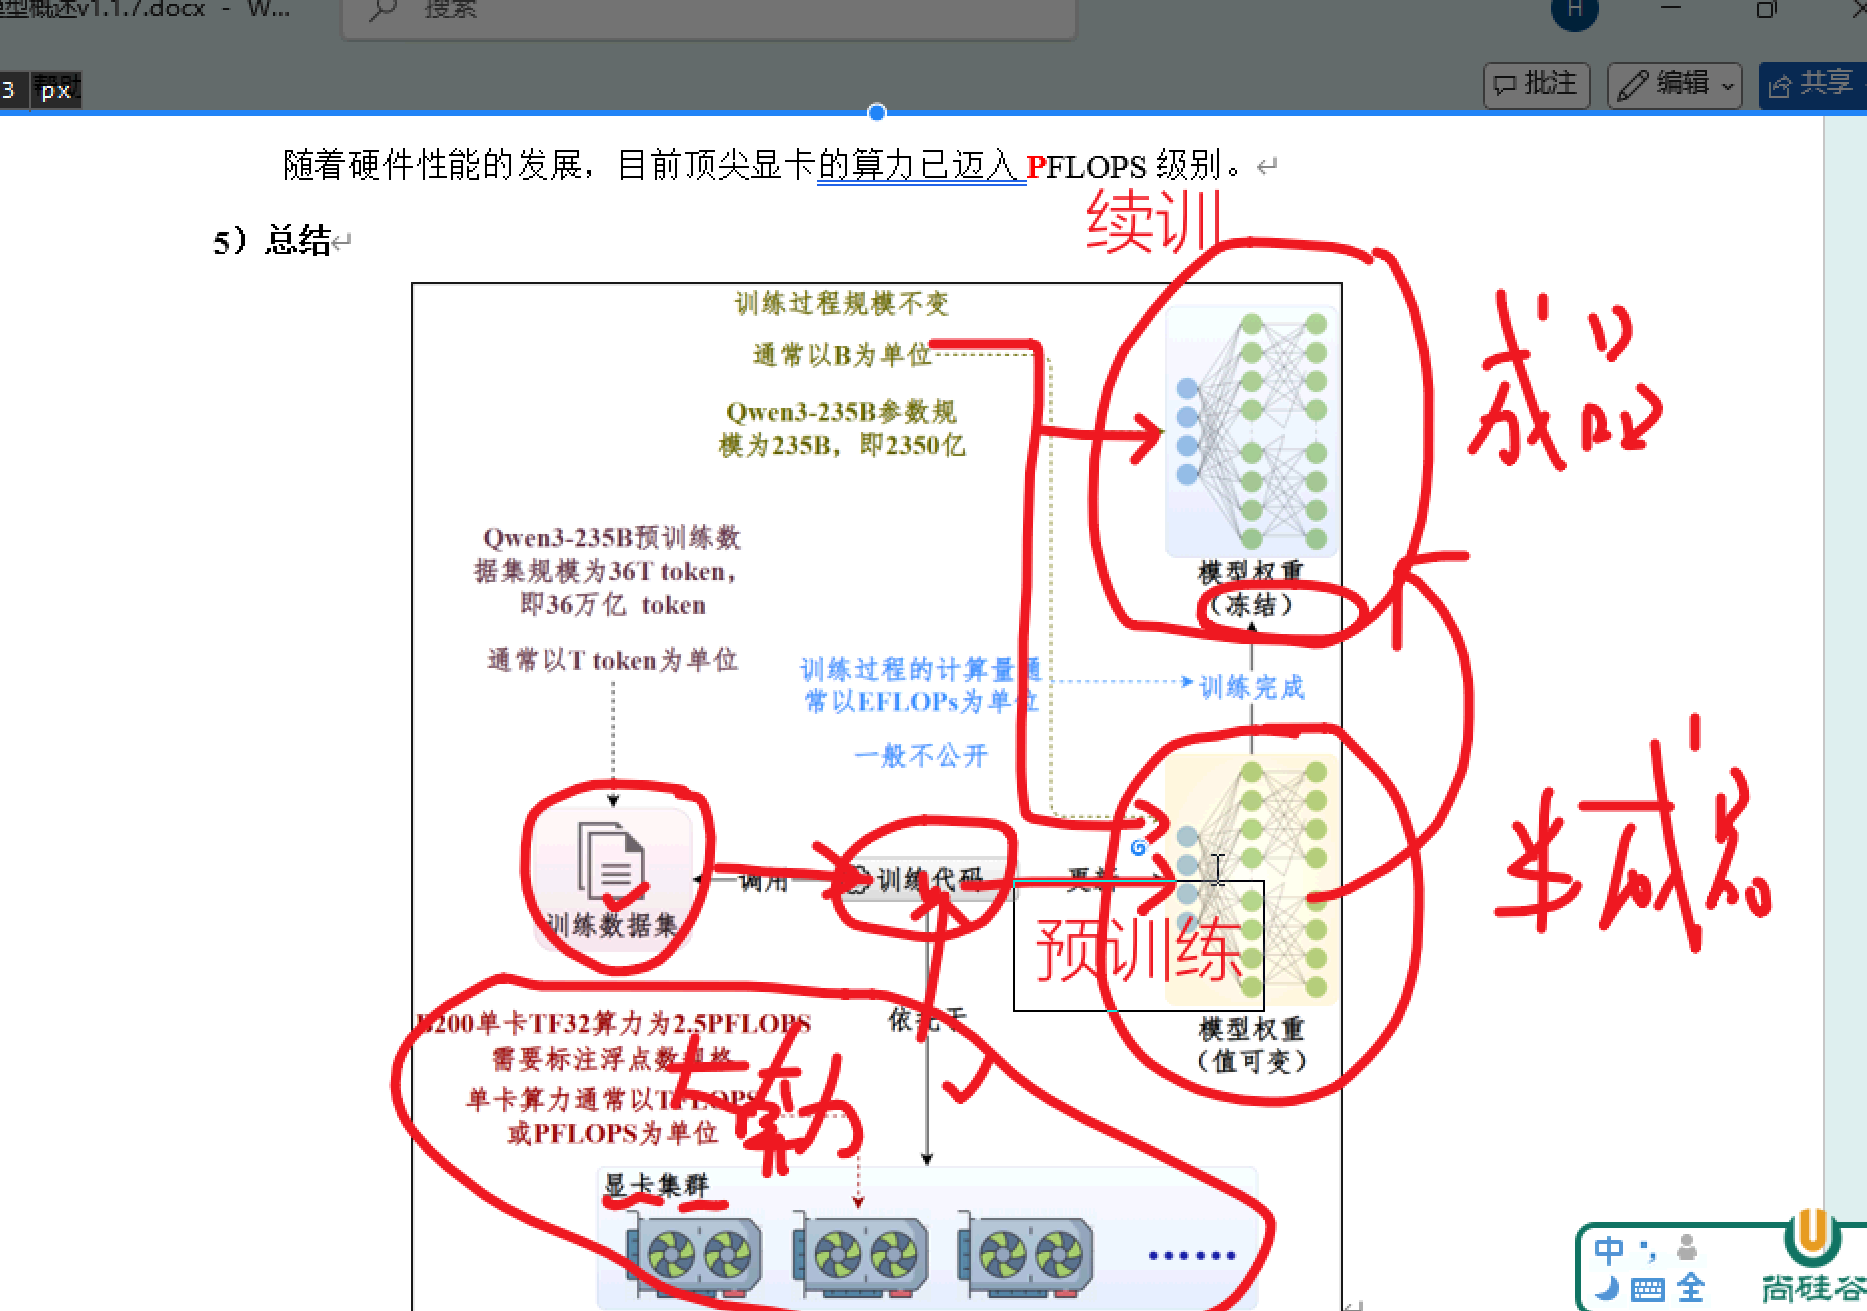
- 参数规模,通常以 B 为单位,Billion 的缩写,即十亿(10⁹)
- 训练数据规模
- 计算规模(算力):FLOPS ——> 每秒浮点运算次数
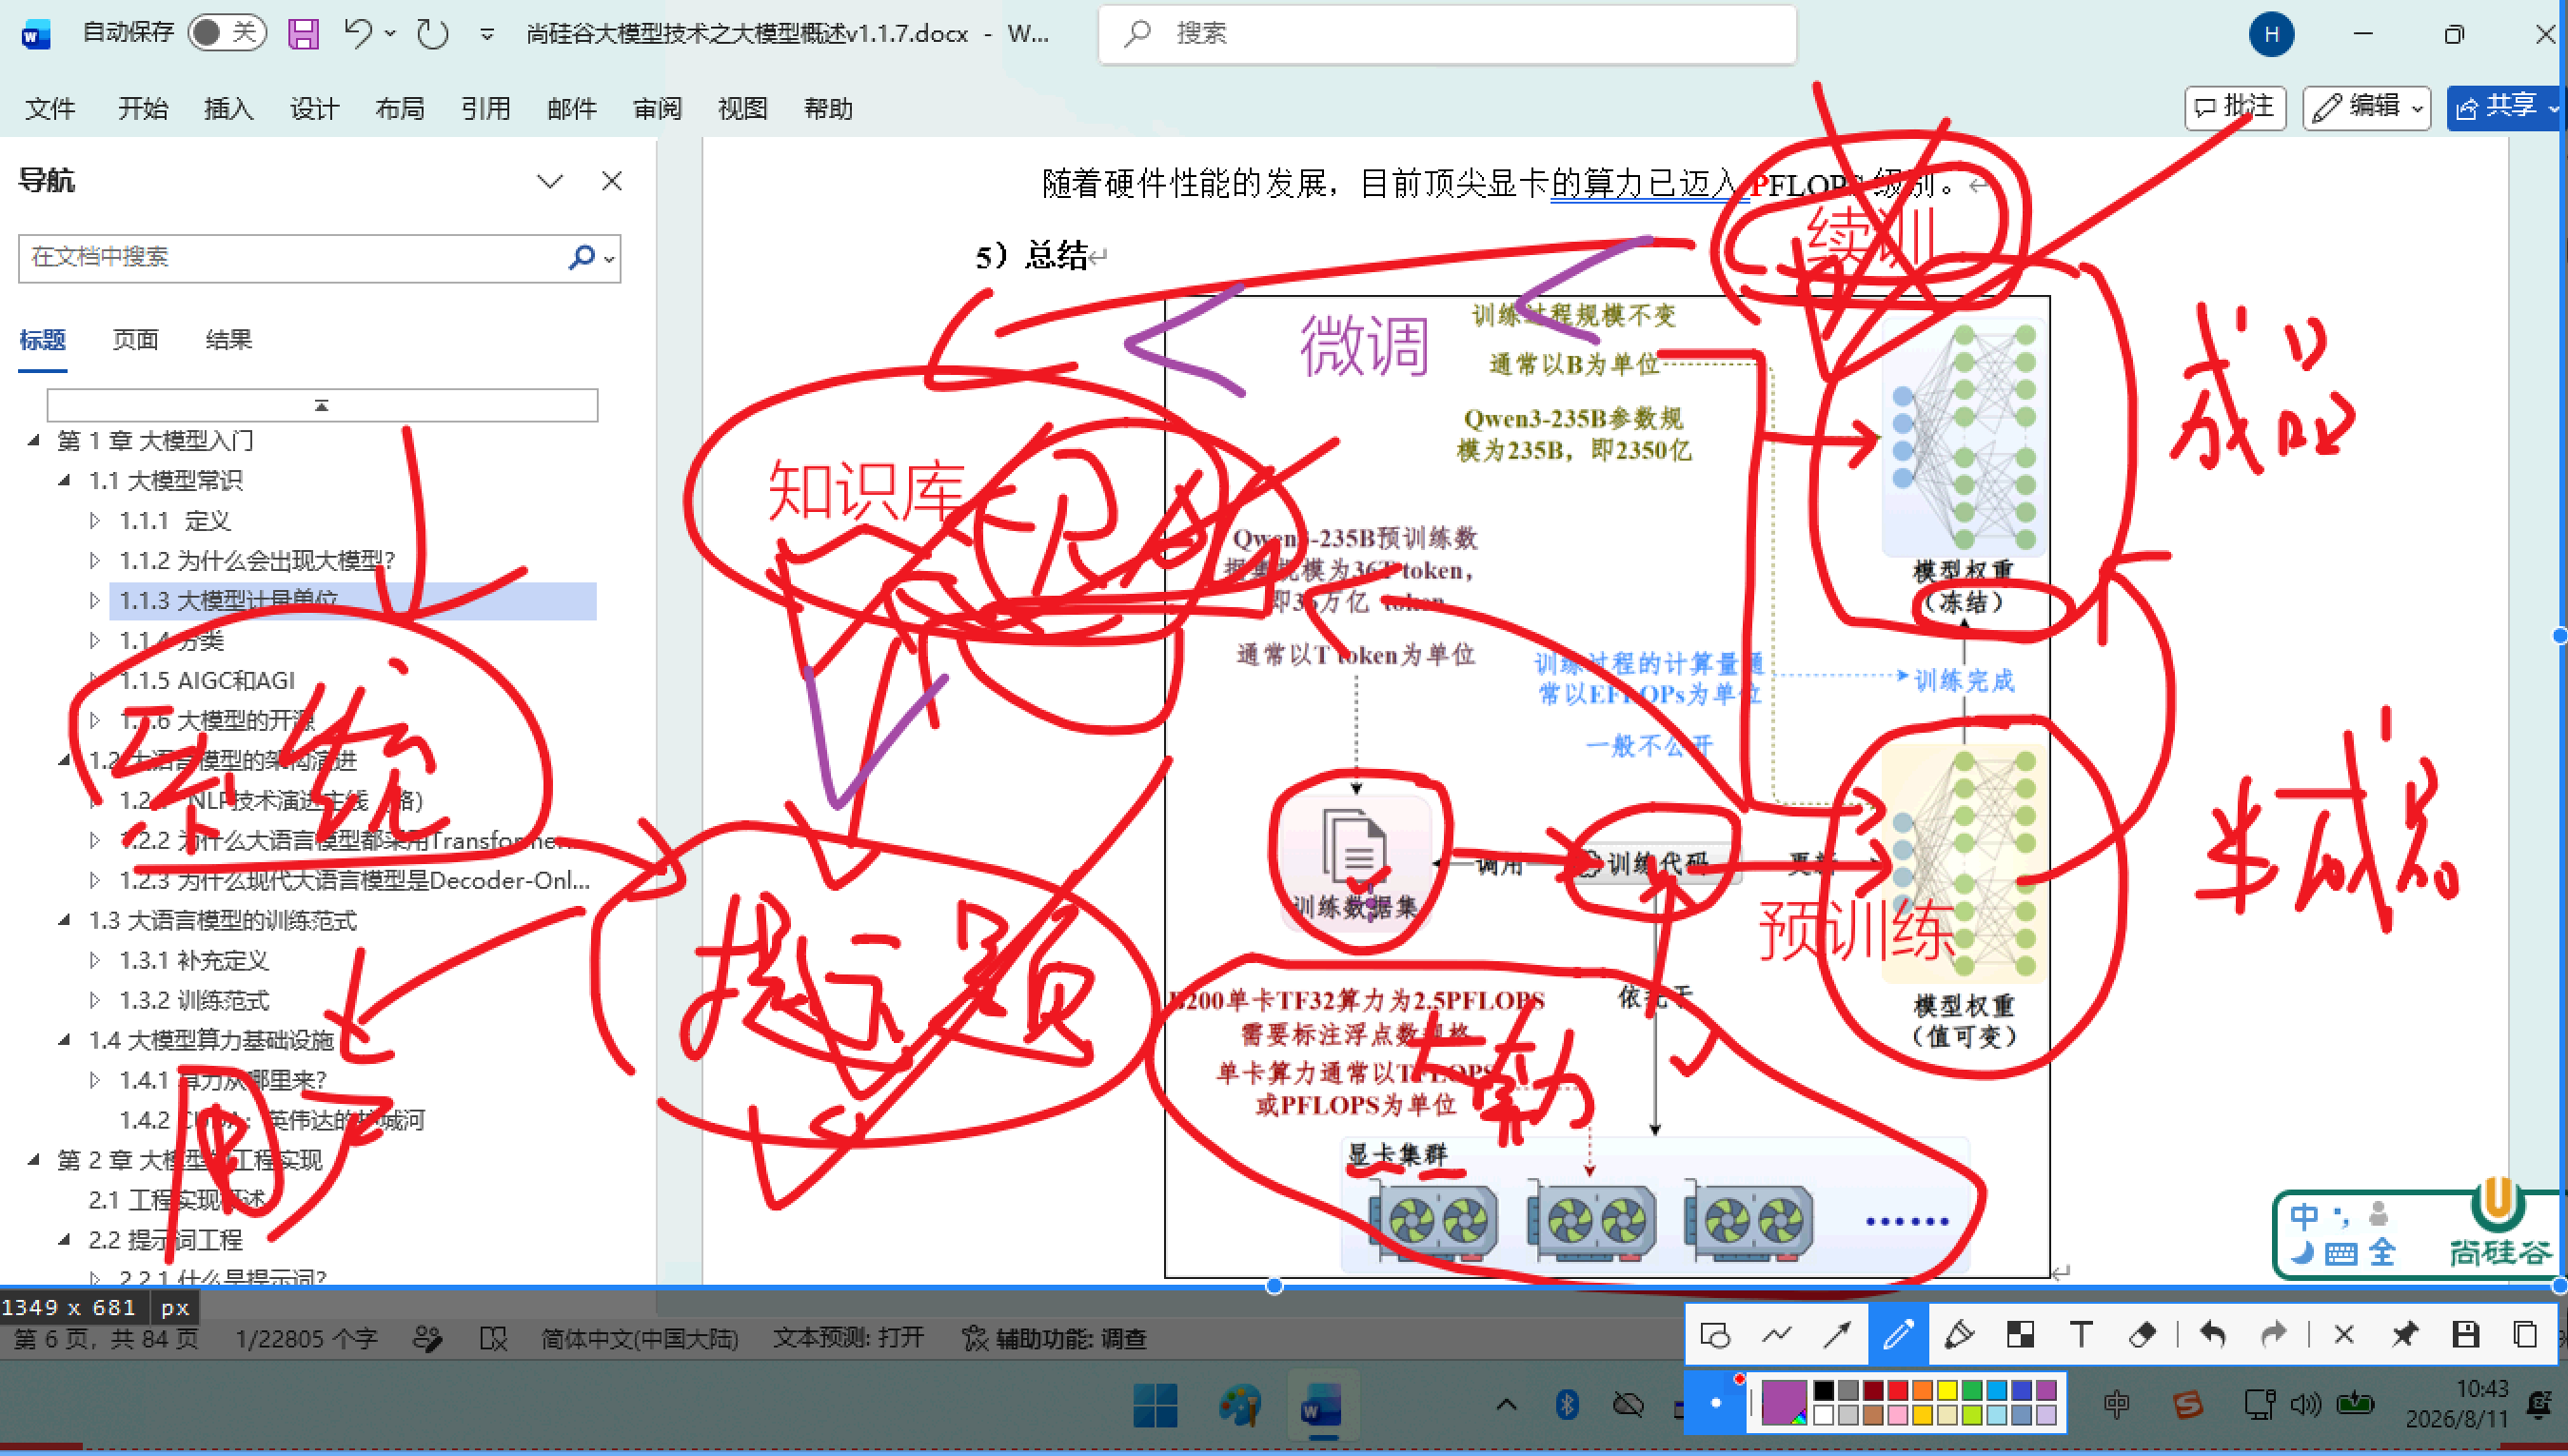
续训 外部知识库通过 RAG 技术来辅助,访问知识库来满足用户要求
补充整理:原稿中几处需要修正的地方——
- 「B 即 10 万」有误:B = Billion = 十亿(10⁹),不是十万。7B 就是 70 亿参数
- 「PAG 技术」应为 RAG(Retrieval-Augmented Generation,检索增强生成)
- 「浮点运策略」应为 FLOPS(Floating Point Operations Per Second,每秒浮点运算次数)
- 原稿「BGR-Rerankder」应为 BGE-Reranker(智源 BGE 系列的重排序模型)
续训指的是在已有预训练模型基础上继续训练,让模型吸收新领域知识—— 它和 RAG 是两条不同的路:续训是把知识写进参数,RAG 是外挂知识库现查现用。 时效性强的知识适合 RAG(改库即可生效),风格/能力迁移适合微调或续训。
按照模型功能/输出形态分类
- 生成式模型(用户用的多):LLM、多模态理解模型、多模态生成模型
- 嵌入模型/向量表征模型:将文字转换成向量(一串浮点数)
- 重排序/相关性打分模型(Rerank/Scoring Model):BGE-Reranker
- 分类器/判断模型:判断需求是什么,有很多分支
补充整理:这张分类表对做 RAG 特别重要,因为一个 RAG 系统至少要用到两类模型——
类型 在 RAG 里的角色 典型代表 嵌入模型(Embedding) 把文档块和用户问题都转成向量,用于「召回」 BGE-M3、text-embedding-3 重排序模型(Reranker) 对召回结果精排,提升 Top-K 的准确度 BGE-Reranker-v2、Cohere Rerank 生成模型(LLM) 拿到精排后的上下文,组织语言作答 Qwen、DeepSeek、GPT 常见架构是两阶段检索:先用向量召回几十条(快但粗),再用 Reranker 精排出前 3–5 条 (慢但准),最后交给 LLM。只做向量召回、不加 Rerank,是很多 RAG 效果不佳的原因之一。
另外,嵌入模型输出的是稠密向量(浮点数数组),不是「二进制」——这点原稿表述不准。
生成模型
又称(大语言模型)
多模态理解模型
补充整理:原稿这一节只留了几个模型名,且拼写有误,这里补充完整背景——
- 文生视频方向:可图/可灵(Kling)、海螺(Hailuo)、Veo 等,国产与海外都有多个产品线
- 字节的 Seedance 系列是其中一个视频生成模型(原稿「seedancd2.5」应为此)
- 「pixmax」「oiioii」原稿无法辨认,暂不作断言——建议后续对照课件补齐具体型号
多模态模型的通用思路是把图像/音频/视频编码成与文本同一空间的 token, 然后交给同一个 Transformer 处理,这也是「理解」和「生成」能统一在一套架构下的原因。
AIGC 和 AGI
- AIGC:通过智能设备生成对应的内容
- AGI:和大模型一样,AGI 没有统一定义,指通用人工智能
大语言模型的训练范式
==> 训练范式:预训练 + 后训练 SFT(Supervised Fine-tuning,监督微调) RLHF(Reinforcement Learning from Human Feedback,人类反馈强化学习)
- 预训练:学语言(不具备对话能力)
- SFT:学指令(对答案优劣和边界约束,哪些内容不能输出)
- RLHF/RLAIF:通过人类或 AI 干预方式让其与人类对齐
补充整理:原稿把 RLHF 写成了「from AI feedback」,这是错的——
- RLHF = Reinforcement Learning from Human Feedback(人类反馈)
- RLAIF = Reinforcement Learning from AI Feedback(AI 反馈,用模型代替人类打分)
三阶段的直觉理解:
阶段 学什么 产物 预训练 语言的统计规律、世界知识 基座模型(只会「续写」,不会「回答」) SFT 指令格式与回答范式 指令模型(能对话) RLHF/RLAIF 什么样的回答更好、更安全 对齐后的可用模型 一个实用结论:基座模型直接拿来用常常「答非所问」——它会续写而不是回答。 所以做应用时务必选带
-Instruct/-Chat后缀的版本。
硬件基础
CPU、GPU、TPU、NPU
补充整理:为什么是 GPU 而不是 CPU——
芯片 特点 主要用途 CPU 核少但强,擅长复杂逻辑与串行任务 通用计算、服务编排 GPU 核多而简单,擅长大规模并行矩阵运算 训练与推理主力 TPU Google 定制的矩阵运算专用芯片 大规模训练 NPU 端侧低功耗推理芯片 手机/PC 本地推理 训练看的是算力 + 显存带宽,推理看的是显存容量 + 访存带宽。 所以「能不能跑起来」取决于显存,「跑多快」取决于带宽。
提示词工程
提示词指的是用户与大模型交互时输入的内容(用户提示词)
补充整理:提示词工程的几条硬经验——
- 说清楚角色、任务、格式、约束,比「请帮我写好一点」有效得多
- 给示例(few-shot) 比反复解释规则更省 token、也更稳定
- 把复杂任务拆成多步,让模型一步步来(Chain of Thought),准确率明显提升
- 重要信息放开头和结尾:长上下文里,中段内容最容易被忽略
- 约束要写成正向指令:「只输出 JSON」好过「不要输出多余的话」
提示词能解决的是「怎么把话说清楚」,解决不了「模型不知道这件事」—— 后者要靠 RAG 或微调。这是选择技术方案时的分水岭。