Day 4 · 常用核心类、异常、Lambda 与 Stream
包装类
对八种基本类型进行包装:基本数据类型 → 引用数据类型。
| 基本类型 | 包装类 |
|---|---|
byte | Byte |
short | Short |
int | Integer |
long | Long |
float | Float |
double | Double |
char | Character |
boolean | Boolean |
装箱与拆箱
- 装箱:把基本类型转换为包装类
- 拆箱:把包装类转换为基本类型
装箱
Integer num1 = Integer.valueOf(1);   // 推荐,走缓存
Integer num2 = new Integer(1);       // 已废弃(JDK 9 起),不要用
拆箱
int intNum = num1.intValue();自动拆装箱
Integer num = 1;      // 自动装箱,等价于 Integer.valueOf(1)
int intNum = num; // 自动拆箱,等价于 num.intValue()补充整理:原稿里的
Interger是拼写错误(正确是Integer),已修正。 另外三个实战要点:
new Integer(...)/new Double(...)等构造器在 JDK 9 起被标记废弃,一律用valueOf()。- 自动拆箱时若包装对象是
null,会抛NullPointerException:Integer count = null; int n = count;看着人畜无害,是线上常见 NPE 来源。- 泛型、集合里只能放引用类型,这正是包装类存在的主要理由;
List<Integer>能直接add(1)靠的就是自动装箱。
String 与 int 相互转换
补充整理:原稿这里只有标题,补上双向写法。
java// String → int / Integer:用 parseXxx 或 valueOf,别用 new Integer(str) int a = Integer.parseInt("123"); Integer b = Integer.valueOf("123"); // int / Integer → String:三种都行,valueOf 最不容易踩空指针 String s1 = String.valueOf(123); String s2 = Integer.toString(123); String s3 = 123 + ""; // 能跑但不推荐,会多造临时对象
parseInt返回基本类型int,valueOf返回包装类型Integer; 字符串格式不合法会抛NumberFormatException(运行时异常),转型前最好先校验或 try-catch。
装箱的缓存机制
只在 -128 ~ 127 会复用,不会新建一个,地址相同。
补充整理:这句是关键考点,展开一下——
Integer.valueOf(n)在-128 ~ 127之间直接返回缓存好的同一个对象, 超出范围才new。所以:javaInteger a = 127, b = 127; System.out.println(a == b); // true,同一缓存对象 Integer c = 128, d = 128; System.out.println(c == d); // false,两个不同对象 System.out.println(c.equals(d)); // true,值相等包装类比较值一律用
equals(),不要用==(==比的是对象地址)。 缓存覆盖-128 ~ 127的还有Byte、Short、Long、Character(0 ~ 127);Float/Double没有缓存;Boolean只缓存TRUE/FALSE两个。 上限 127 可通过 JVM 参数-XX:AutoBoxCacheMax调大。
String 类
字符串的不可变性
补充整理:原稿只有一句标题。
String内部用final修饰的byte[](JDK 9 之前是char[]) 存值,且不提供任何修改它的方法。所谓「改字符串」其实都是生成新对象。 不可变带来的好处:可以安全地做字符串常量池复用、天然线程安全、hashCode 可缓存 (所以String才适合当HashMap的 key)。 代价是频繁拼接会产生大量临时对象,所以循环里绝不能用+。
拼接字符串
- 用
+拼接符号:str1 + str2 - 使用
StringBuffer - 使用
StringBuilder - 新特性:
String.join("", "hello", "world")
补充整理:四者怎么选——
方式 适用 原因 +少量、非循环的拼接 编译器会优化成 StringBuilder,写起来最简洁StringBuilder循环内、单线程 可变对象,全程只创建一个;默认首选 StringBuffer多线程共享同一个缓冲区 方法加了 synchronized,比StringBuilder慢String.join用分隔符拼接一批字符串 语义最清楚,如 String.join(",", list)注意循环里写
s += x是每次迭代都新建一个StringBuilder,数据量大时性能差距能到几个数量级。 另外StringBuilder本身不是线程安全的,但绝大多数场景它是局部变量,根本不会有共享问题, 所以别一上来就用StringBuffer。
日期
补充整理:原稿这里只写了个「敲」字,补一版现代写法。 别再用
java.util.Date和SimpleDateFormat:前者可变且设计混乱, 后者不是线程安全的,在 Web 服务里当静态变量用会串数据。javaimport java.time.*; import java.time.format.DateTimeFormatter; LocalDate today = LocalDate.now(); LocalDate d = LocalDate.of(2026, 11, 4).plusDays(7); LocalDateTime now = LocalDateTime.now(); DateTimeFormatter fmt = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss"); String text = now.format(fmt); LocalDateTime parsed = LocalDateTime.parse("2026-11-04 16:00:00", fmt); long days = ChronoUnit.DAYS.between(today, d);
java.time(JSR-310,JDK 8 起)里的类全是不可变且线程安全的。 存时间戳用Instant,带时区用ZonedDateTime,只记年月日用LocalDate。
异常处理机制
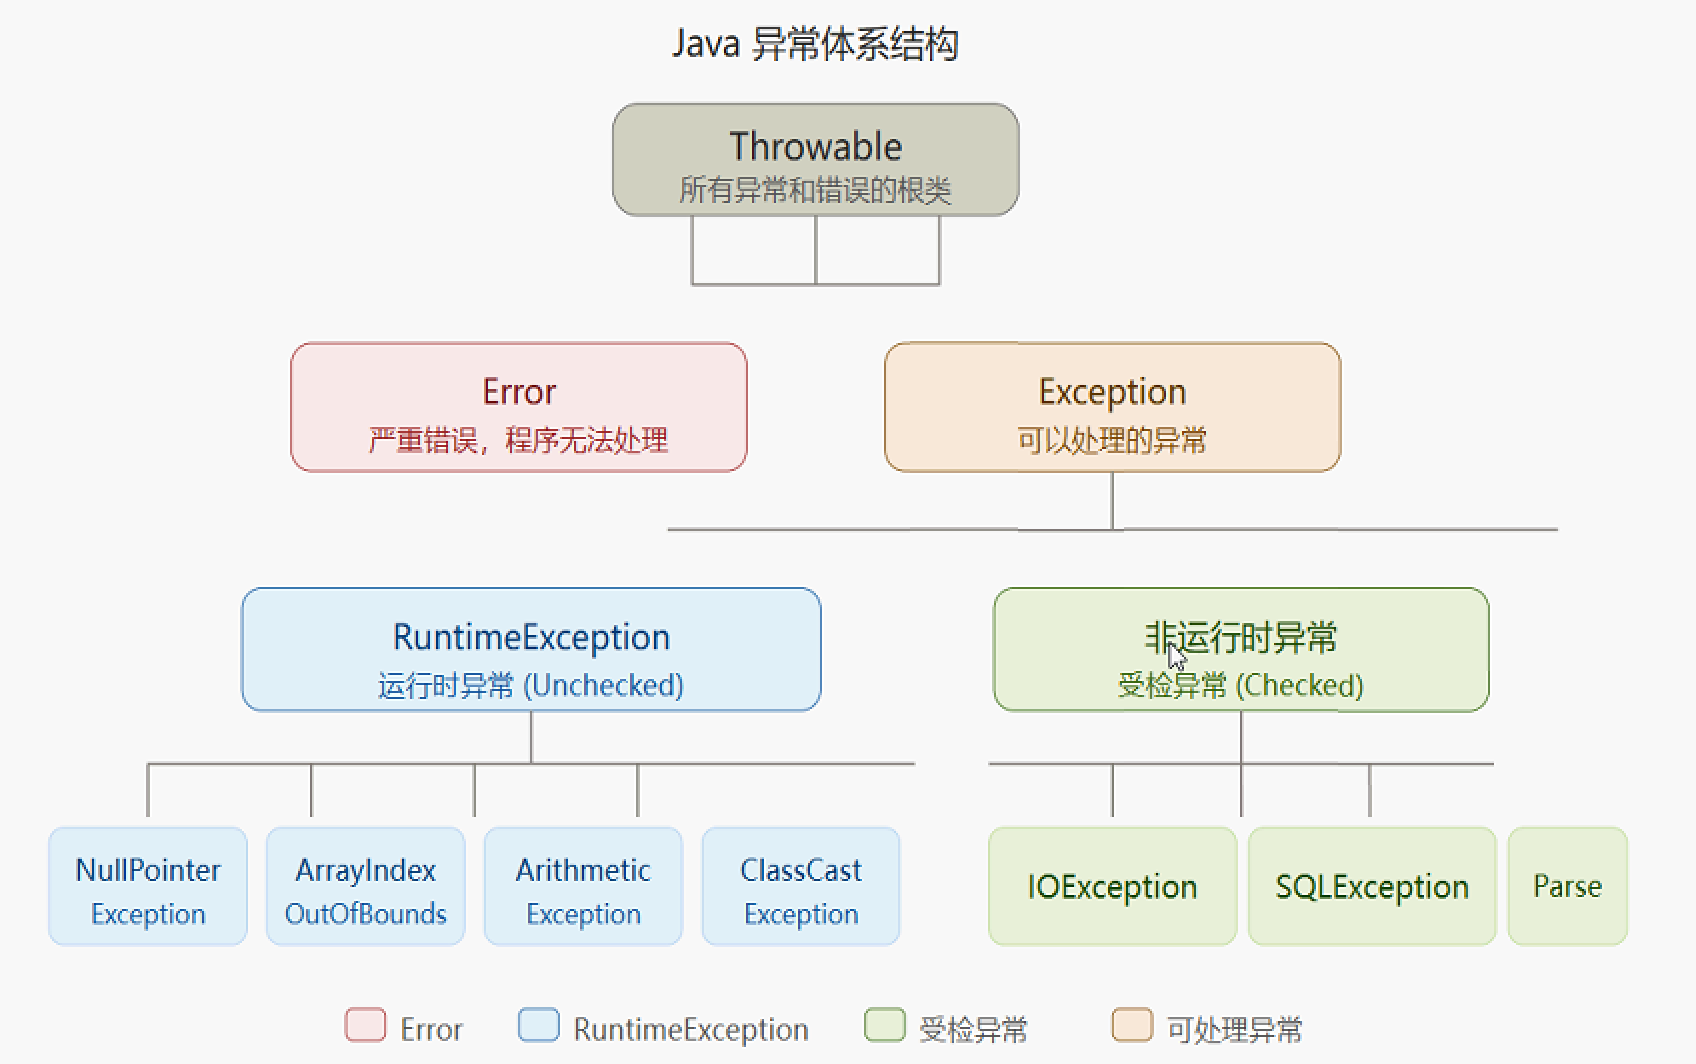
Java 中所有异常的父类是 Throwable:
Error:错误,程序无法处理(如OutOfMemoryError)Exception:可以处理的异常
除了
RuntimeException(只有运行的时候才会有异常)以外都是编译期异常。
补充整理:这句要说得更准一点——
Throwable分两支,Exception下再分RuntimeException(运行时异常 / 非受检)和其余的受检异常(Checked);Error既不是受检异常也不是运行时异常,它压根不该被 catch。
类型 编译器是否强制处理 例子 Error不强制,也不该捕获 OutOfMemoryError、StackOverflowError运行时异常 RuntimeException不强制 NullPointerException、ArrayIndexOutOfBoundsException、算术异常、类型转换异常受检异常(其他 Exception)强制:不处理就编译不过 IOException、SQLException、ParseException记忆点:受检异常是「外部环境可能出问题,编译器逼你想清楚怎么办」, 运行时异常是「代码写错了,应该改代码而不是 catch」。
单异常处理
三种组合,按需取舍:
- 既要处理异常,也要释放资源 →
try-catch-finally - 没有异常处理,但要释放资源 →
try-finally - 有异常处理,但不需要释放资源 →
try-catch
try {
    // 捕获异常:放可能出问题的代码
} catch (异常类型 变量名) {
    // 处理异常
} finally {
    // 释放资源:一定会执行
}补充整理:
finally「一定会执行」有少数例外:System.exit()、JVM 崩溃、 线程被强行中断。还有一个高频坑——不要在finally里return, 它会把try/catch里的返回值甚至异常全部吞掉。 另外 JDK 7 之后,finally手工关流的写法基本可以被 try-with-resources 取代。
多异常处理
try { ... }
catch (A异常 | B异常 e) { ... }   // 多个异常同一套处理逻辑
catch (Exception e) { ... } // 再兜底:多态直接用父类异常补充整理:
catch的顺序必须先子类后父类,把catch (Exception e)写在最前面, 后面的具体异常分支永远走不到,编译器会直接报「已捕获异常」。 多异常|连接的几个类型之间不能有继承关系(写IOException | Exception会报错)。 捕获后至少要打日志或向上抛,空 catch 块是排查问题时最难受的东西。
throws 关键字
也是用来处理异常,写在方法声明上,告诉调用者这个方法可能会出现某种异常; 调用者必须处理或者继续向上抛出。本质是把异常抛给别人处理。
三层架构里的分工:
控制层(与客户端交互) → 业务层(一般异常处理都在业务层) → 持久层(操作数据库)若在持久层发生异常,不应该在持久层里 try 掉,而要把异常抛给业务层,这时就用 throws。
补充整理:为什么不在持久层自己 catch?因为只有业务层知道该怎么补救 (回滚事务、转成用户能看懂的提示、降级返回默认值),持久层吞掉异常会让上层 误以为操作成功,比直接报错危险得多。
一条规则:重写方法时,子类
throws的异常不能比父类更大(和 Day 3 的重写规则一致); 接口方法没声明受检异常,实现类就不能抛受检异常。所以自定义异常常做成运行时异常, 就是为了不被这层约束绑住。
try-with-resources
try (资源创建) {
    // 使用资源
} catch (Exception e) {
    e.printStackTrace();
}补充整理:原稿这段是伪代码(
sout、printStatckTrace),补一个能跑的版本。 括号里的资源必须实现AutoCloseable,无论是否抛异常都会自动关闭, 不用再写finally:javatry (BufferedReader br = Files.newBufferedReader(Path.of("data.txt"))) { System.out.println(br.readLine()); } catch (IOException e) { e.printStackTrace(); // 生产环境请改用日志框架,别直接 printStackTrace }可以声明多个资源,用分号隔开,关闭顺序与声明顺序相反。 若
try块和close()都抛异常,前者正常抛出、后者作为 suppressed 异常附在后面, 不会像手写finally那样把主异常覆盖掉——这是它比finally更可靠的关键。
throw 关键字
throws不会自己产生异常,把原有的异常抛给调用者throw会自己产生异常,把产生的异常抛给调用者
throw new IllegalArgumentException("金额必须大于 0");自定义异常
- 运行时异常:运行时才会有异常
- 编译期异常:写代码就得处理
- 一般自定义的是运行时异常
throw new BusinessException("转账金额必须大于 0", 1001);补充整理:
throw后面跟的是一个异常对象(所以必须有new), 写在方法体里;throws后面跟的是异常类型列表,写在方法签名上,可以逗号分隔多个。 自定义业务异常通常继承RuntimeException,带上错误码方便上层统一转响应:javapublic class BusinessException extends RuntimeException { private final int code; public BusinessException(String msg, int code) { super(msg); this.code = code; } public int getCode() { return code; } }配套做法是在控制层用
@RestControllerAdvice+@ExceptionHandler统一兜底, 业务代码里只管throw,不用到处 try-catch。
Object 类
自定义的类都可以使用 Object 类中的方法:
hashCode():返回对象的哈希码值(用于判断两个对象是否是相同对象,相同对象哈希码相同)注意:有可能重写
hashCode()导致不同对象哈希码相同(哈希冲突)getClass():返回该对象运行时类的Class对象Hello.java--javac-->Hello.class--java--> 加载到 JVM 拿到Class对象后就可以反射:获取构造器、成员方法、成员变量、注解等同一个类的运行时
Class对象是同一个对象getName():返回全类名(包名.类名)toString():返回「全类名@哈希码值」。直接打印对象名默认调用toString(),一般要重写equals():比较两个对象是否「相等」,默认用==比地址;想要比值就得重写,大部分场景都需要
补充整理:原稿把
getName()列进了Object的方法,其实它是Class类的方法, 正确写法是obj.getClass().getName();Object自带的 11 个方法里,常用的还有clone()、finalize()(已废弃)、以及多线程的wait()/notify()/notifyAll()。重写
equals必须同时重写hashCode,这是硬契约:equals相等的两个对象,hashCode必须相等。违反它的直接后果是—— 放进HashSet/HashMap时明明「相等」却存了两份、或get取不出来 (Day 5 的 HashSet 去重就依赖这条)。IDE 可以一键生成,记得两个一起勾上。
toString()默认的类名@16进制哈希基本没有可读性,日志排查时很痛苦, 建议所有实体类都重写(Lombok 的@Data会顺带生成)。
Lambda 表达式
新东西,写法上靠近 Python。
函数式接口
只有一个抽象方法的接口(有其他方法无所谓),配合函数式编程 + @FunctionalInterface 标记。
所谓函数式编程就是 Lambda 表达式:Lambda 是匿名内部类的语法糖(简化)——接口名和方法名都不需要,只保留参数括号和语句体。
- Lambda 语句体只有一行代码,可以省略大括号
- 语句体只有一行且为
return,可以省略大括号和return - 如果传入的形参只有一个,可以将类型和小括号省略
// 匿名内部类
Runnable r1 = new Runnable() {
    @Override public void run() { System.out.println("hi"); }
};

// Lambda
Runnable r2 = () -> System.out.println("hi");补充整理:还有两条省略规则:形参类型通常可以全省(编译器按函数式接口推断), 要么全写要么全不写,不能只省一部分;
x -> x * 2这种单参数单表达式是最简形态。 反过来,多语句时必须写{ }和return。另外 Lambda 里引用的外部局部变量同样要求 effectively final(Day 3 匿名内部类那一节讲过原因), 但它和匿名内部类有个本质区别:Lambda 里的
this指向外部类对象, 匿名内部类里的this指向那个内部类对象自己。
五种函数式接口
1. Supplier 接口 —— 无入参,对外提供数据
@FunctionalInterface
public interface Supplier<T> {   // T 为不确定类型的数据
    T get();                     // 用来获取一个泛型参数指定类型的对象数据
}
2. Consumer 接口 —— 接收数据并处理
注意:泛型的数据类型只能是引用数据类型,例如不能写
int,只能写Integer。
@FunctionalInterface
public interface Consumer<T> {
    void accept(T t);
}
3. Function 接口 —— 接收数据之后,根据接收的数据传回一个数据(一般用来类型转换)
@FunctionalInterface
public interface Function<T, R> {   // 两个泛型 T、R
    R apply(T t);                   // 接收 T 类型参数,返回 R 类型结果:转换映射
}
4. BiFunction 接口 —— 接收两个数据,返回一个数据
@FunctionalInterface
public interface BiFunction<T, U, R> {
    R apply(T t, U u);
}
5. Predicate 接口 —— 用来做数据校验、判断
@FunctionalInterface
public interface Predicate<T> {
    boolean test(T t);
}补充整理:这五个都来自
java.util.function,按「要不要参数、要不要返回值」记比死记名字快:
接口 入参 返回 典型用途 Supplier<T>无 T懒加载、造默认值 Consumer<T>1 个 无 遍历、打印、写库 Function<T,R>1 个 R映射 / 类型转换 BiFunction<T,U,R>2 个 R二元运算、合并 Predicate<T>1 个 boolean过滤、校验 还有两个常见的:返回基本类型的
ToIntFunction、以及Supplier的特化IntSupplier等,目的都是避免自动拆装箱的开销。 参数个数超过 2 个时 JDK 没有内置接口,得自己定义一个函数式接口。
方法引用
方法引用是 Lambda 表达式的语法糖(更加简洁)。
三个条件:
- Lambda 方法体内只有一条语句,且这条语句就是单纯一个方法调用
- 参数传递的方式必须完全对齐(传入参数在语句体里有一一对应的位置)
- 返回值类型兼容(内部方法返回值和执行的方法返回值一样)
五个场景:
- 实例方法引用:
对象名.方法名→对象名::方法名,通过对象调用方法System.out其实是一个对象,System.out::println传入什么就打印什么 - 静态方法引用:
类名.方法名→类名::方法名,通过类调用方法 - 无参构造方法引用(Supplier 接口):
new 类名()→类名::new - 有参构造方法引用(Function / BiFunction 接口):
new 类名(参数)→类名::new无参和有参光看方法引用都是
类名::new,看不出引用的是哪个构造器,得看调用方法里传了几个参数 - 数组的方法引用:
new int[length]→int[]::new
补充整理:还有一种原稿没列的 「类名::实例方法」(任意对象的实例方法引用), 最容易搞混:
String::compareToIgnoreCase等价于(a, b) -> a.compareToIgnoreCase(b), 第一个参数自动成为方法调用者。Stream 里map(String::length)也是这一类。判断用哪种,只需要看 Lambda 里那唯一一行是谁在调用方法: 已有对象 →
对象::方法;静态 →类名::方法;第一个参数当调用者 →类名::实例方法; 是new→类名::new。方法引用不能凭空造逻辑(比如x -> x * 2 + 1就没法引用)。
流操作
数组的两种开流方式:
Arrays.stream(arr);   // (1) 数组转流
Stream.of(arr);       // (2) 直接由元素创建流
中间操作
返回的依然是流,可以链式串下去。
| 方法 | 作用 | Python 对应 |
|---|---|---|
filter(Predicate) | 过滤 | filter() / 列表推导式 if |
map(Function) | 映射转换 | map() / 列表推导式表达式 |
sorted() | 排序 | sorted() |
distinct() | 去重 | set() |
limit(n) | 取前 n 个 | [:n] |
skip(n) | 跳过前 n 个 | [n:] |
终结操作
调用之后流就不能再复用了。
| 方法 | 作用 | Python 对应 |
|---|---|---|
collect(Collector) | 收集为 List / Set / Map 等 | — |
forEach(Consumer) | 遍历 | for...in |
count() | 计数 | len() |
reduce(BinaryOperator) | 归约(累加、累积) | functools.reduce |
anyMatch(Predicate) / allMatch(Predicate) | 任一匹配 / 全部匹配 | any() / all() |
findFirst() | 找第一个 | next() |
max(Comparator) / min(...) | 最大最小 | max() / min() |
补充整理:原稿写的
Array.stream()少了s,正确是Arrays.stream(...)。「中间操作返回流」还隐含一个关键特性——惰性求值:只写
filter/map不会执行任何计算, 必须碰到终结操作才真正跑起来。所以打印日志别写在map里指望它一定执行。两个常见坑:
- 流只能消费一次,终结操作后再用会抛
IllegalStateException: stream has already been operated upon or closed;需要复用就收集成集合再开新流。Collectors.toMap遇到 value 为null会抛 NPE,且重复 key 默认抛IllegalStateException,要显式给合并规则(a, b) -> a。javaList<String> names = users.stream() .filter(u -> u.getAge() >= 18) .map(User::getName) .collect(Collectors.toList());
Optional 和 Stream 结合
获取数据 → 判断数据(有 / 无,给默认值)→ 处理数据,所以新特性里把这套流程集成了。
.orElse(默认值):没有值就给默认值.ifPresent(...):有才执行,没有不执行
// findFirst 返回 Optional
Integer[] nums = {3, 1, 2, 5, 4};
Optional<Integer> first = Arrays.stream(nums)
    .filter(n -> n > 4)
    .findFirst();

int value = first.orElse(100);          // 不存在返回 100
first.ifPresent(System.out::println); // 存在则打印 5补充整理:原稿这段有两处跑不通 / 对不上,已修正——
- 数组没有
.stream()方法,必须写Arrays.stream(nums)或Stream.of(nums);- 注释写「不存在返回 -1」但代码写的是
orElse(100),以代码为准,统一成 100。顺便补一条实践建议:优先用
orElseGet(Supplier)而不是orElse(...)。orElse的参数会无条件先算出来(哪怕 Optional 里明明有值), 如果默认值构造很贵(查库、发请求)就白算了;orElseGet只在没值时才执行。 另外Optional设计定位是方法返回值,不要拿它当字段、参数或放进集合, 更不要无脑optional.get()(等于绕回 NPE),用orElse/orElseThrow/map更安全。
什么时候用流
| 场景 | 推荐 |
|---|---|
| 集合过滤、转换、统计 | 用 Stream |
需要中途 break / continue | 不用,用普通 for |
| 需要修改原始集合 | 不用,用迭代器或普通 for |
| 简单遍历打印 | 用 forEach 或增强 for |
注解(Annotations)
以 @ 开头的都是注解,可以放在类、方法、字段上。
给程序附加标签,本身不影响业务,但可以被编译器或框架读取并处理(底层用的是反射)。 语法:
@注解名或@注解名(参数名 = 值)。
内置注解
1. JDK 内置注解
@Override:标记是重写方法@Deprecated:表示变量、类、方法过时@SuppressWarnings("警告类型"):压制警告,"all"压制所有警告@FunctionalInterface:标记是一个函数式接口
2. 元注解(标记注解的注解,自定义注解时用得上)
@Target:规定自定义注解可以作用的范围 / 位置@Retention:自定义注解存活的时间(源码 → 编译期 → 运行时)大部分注解应该设置为运行时;若没有存活到运行时,绝大部分框架读不到、也就没有用
@Documented@Inherited
3. 自定义注解
@元注解
public @interface 注解名 {
    数据类型 参数名() default 值;
}注解的本质:只是一个标记,本身只是标记,需要其他技术支持附加,才会有作用:
- 编译器处理(如
@Override帮你检查重写)- 框架通过反射读取并执行相应逻辑(如 Spring 的
@Component)- 注解处理器(APT)编译期生成代码(如 Lombok 自动生成 getter/setter)
补充整理:
@Retention三档要分清,这是自定义注解最容易写错的地方:
策略 存活到 谁能读 例子 SOURCE源码 编译器 / APT @Override、@DataCLASS.class文件(默认)字节码工具 编译期插桩、AspectJ RUNTIME运行时 JVM 反射 Spring / MyBatis / JUnit 的注解 只有在运行时用
method.getAnnotation(Xxx.class)读的注解,才必须写@Retention(RetentionPolicy.RUNTIME),否则反射拿到的永远是null。@Target常用值:TYPE(类 / 接口)、FIELD、METHOD、PARAMETER、ANNOTATION_TYPE。 注解参数的类型只能是基本类型、String、Class、枚举、注解,以及它们的数组。
4. 常见注解
| 框架 | 常见注解 | 作用 |
|---|---|---|
| Spring | @Component、@Service、@Controller、@Repository | 标记为 Spring Bean(标记实体框架) |
| Spring | @Autowired、@Resource | 自动注入依赖 |
| Spring MVC | @RequestMapping、@GetMapping、@PostMapping | 映射 HTTP 请求 |
| MyBatis | @Select、@Insert、@Update、@Delete | 标记 SQL 语句 |
| Lombok | @Data、@Getter、@Setter、@Builder | 自动生成样板代码 |
| JUnit | @Test、@BeforeEach、@AfterEach | 标记测试方法 |
单元测试
JUnit 是 Java 最流行的单元测试框架:
- 测试代码与业务代码分开
- 没有单元测试,靠
main方法测试需要肉眼比对 - 没有单元测试就不能自动化测试
环境准备
JUnit 5 → 后续会用 JUnit 6,六和五用法一样,只是更新。
第一个单元测试
新建一个 lib 目录,把 jar 包复制过去,选中目录右键 Add as Library。
补充整理:手动拷 jar 是课堂里的做法,实际项目一律用 Maven / Gradle 声明依赖, 测试代码放在
src/test/java下,与src/main/java的目录结构一一对应:xml<dependency> <groupId>org.junit.jupiter</groupId> <artifactId>junit-jupiter</artifactId> <version>5.10.2</version> <scope>test</scope> </dependency>JUnit 5 由三部分组成:Platform(运行底座)+ Jupiter(新注解 / 断言 API)+ Vintage(兼容 JUnit 3/4 的老测试)。写新测试只用 Jupiter,注意别把 JUnit 4 的
org.junit.Test和 Jupiter 的org.junit.jupiter.api.Test导混了, 混了的现象是测试「跑不起来但也不报错」。
断言
Assert.assertEquals(a, b):比较两个结果,a是期望的、b是实际的,比较值Assert.assertSame(a, b):比较两个结果,比较地址Assert.assertTrue():判断返回结果是否为trueAssert.assertFalse():判断返回结果是否为falseAssert.assertNotNull():断言不为空Assert.assertNull():断言为空Assert.assertThrows():断言是否抛出指定异常,抛对了才算通过
补充整理:原稿第 3 条把
assertNotNull/assertNull的说明写反了,已对调。再补两点:JUnit 5 里类名叫
Assertions(org.junit.jupiter.api.Assertions),Assert是 JUnit 4 / JUnit 3 的旧类名;assertEquals比较浮点数时必须带误差参数assertEquals(0.1 + 0.2, 0.3, 1e-9),否则精度问题会让测试莫名其妙失败。 另外断言失败时的提示信息写在最后一个参数,写清楚能省很多排查时间。
钩子注解 / 生命周期注解
| 注解 | 执行时机 | 对比 pytest |
|---|---|---|
@BeforeAll | 所有测试之前执行一次(方法必须 static) | setup_module / session fixture |
@AfterAll | 所有测试之后执行一次(方法必须 static) | teardown_module |
@BeforeEach | 每个测试方法之前执行 | setup_method |
@AfterEach | 每个测试方法之后执行 | teardown_method |
其他常用注解(认识即可)
| 注解 | 作用 |
|---|---|
@DisplayName("中文描述") | 给测试起个可读的名字,报告里显示中文 |
@Disabled | 暂时跳过该测试(如功能还没做完),报告标记为「跳过」 |
@ParameterizedTest + @ValueSource | 一组数据跑同一个测试方法 |
为什么一个注解就能跑起来?——用了反射:框架扫描到
@Test标记的方法, 反射调用它,再按断言结果汇总成报告。这和前面 Spring 那套注解的原理是同一回事。